關於
Agent DVR 內建 AI,因此您不需要外部 AI 伺服器來進行物件辨識、人臉辨識或車牌辨識。內建 AI 預設為關閉狀態,您需要啟用它:這需要一個授權金鑰(或有效的訂閱),並且您可以在各個攝影機的物件辨識、人臉辨識或車牌辨識分頁中逐個啟用,將 AI 伺服器保持設定為內部並選擇一個模型(Agent 會為您下載內建模型)。請參閱本機物件辨識。外部 AI 伺服器為選用項目。
如果您想超越內建 AI,Agent DVR 也能完整整合 DeepStack AI、CodeProject AI、PlateRecognizer.com、Claude、Gemini、OpenAI (ChatGPT) 等 AI 伺服器,以及 Ollama、vLLM 和 LM Studio 等本機 LLM,以新增智慧警示篩選、物件辨識、場景辨識和智慧事件控制。
除了 DeepStack 和 CodeProject AI 之外,您也可以使用其他支援相同 API 的 AI 伺服器:
物件辨識 & 電腦視覺
- https://codeproject.github.io/ - 跨平台 GPU/CPU 型 AI 處理伺服器
- https://docs.platerecognizer.com/ - 車牌辨識伺服器(網路型 API)
- https://github.com/runningman84/docker-coral-rest-server - RPi(或 Linux/Mac)上的 Tensorflow-lite 模型,搭配 Coral USB 晶片加速
- https://github.com/robmarkcole/coral-pi-rest-server/ - 經由 Flask 應用程式在 Coral USB 加速器上的 Tensorflow-lite 模型
- https://xnorpx.github.io/blue-onyx/ - Blue Onyx 物件偵測服務
雲端 AI 服務
- https://platform.openai.com/ - OpenAI API (ChatGPT、GPT-4 Vision),用於影像分析和聊天
- https://console.anthropic.com/ - Anthropic Claude API,用於進階推理和影像理解
- https://ai.google.dev/ - Google Gemini API,提供多模態 AI 功能
- https://docs.anthropic.com/ - Claude API 文件
- https://platform.openai.com/docs/ - OpenAI API 文件
- https://ai.google.dev/gemini-api/docs - Gemini API 文件
本地 AI 伺服器 (LLM)
- https://ollama.com/ - Ollama:在本地執行大型語言模型
- https://docs.vllm.ai/ - vLLM:高吞吐量 LLM 推論和服務
- https://lmstudio.ai/ - LM Studio:本地 LLM 的易用桌面應用程式
- https://github.com/ollama/ollama - Ollama GitHub 儲存庫
- https://github.com/vllm-project/vllm - vLLM GitHub 儲存庫
新增 AI 模型
自訂 AI 模型讓您擴展 Agent DVR 的物件辨識超越內建選項,例如辨識野生動物、送貨車輛或任何訓練模型可以找到的東西。若要將您自己的模型檔案新增至 Agent DVR,請前往伺服器設定 > AI 設定,然後在AI 模型下按一下物件辨識。Agent 隨附兩個已針對 Agent DVR 進行效能調整的預先建置模型。
在您設定模型之前,您需要將其新增至 Agent DVR 的模型資料夾(請參閱建置 AI 模型)。這通常位於Agent/Media/Models/ONNX(路徑可能因作業系統而異)。如果您不確定,新增模型頁面上會顯示完整路徑。Agent 使用.onnx模型。您可以使用 Python 工具將其他 AI 模型格式轉換為 ONNX。
建置並複製模型後,將其新增至 Agent 很簡單 - 按一下以新增模型:
- 名稱:為您的模型命名 - 這可以是任何您喜歡的名稱。
- 說明:模型功能的選擇性說明。
- 模型檔案:選擇您複製到資料夾中的模型檔案名稱。
- 標籤清單:輸入模型尋找的標籤(或「類別」)清單,格式為 CSV,不含引號(空格會自動修剪)。
- 佈局:選擇您的模型是 NCHW 還是 NHWC。如果您不確定,大多數模型都是 NCHW。
- 通道順序:選擇您的模型是否需要 RGB 或 BGR 格式的影像。大多數模型使用 RGB。如果您的模型是單通道(灰階),此設定會被忽略。
- 標準化:選擇在將資料用於模型之前應如何標準化。大多數模型使用重新調整 (0-1),即將像素值除以 255。
- 影像填補:這控制影像是應該拉伸到輸入尺寸還是用黑色條紋填補。通常填補影像對精確度更好。
- 具有 NMS:如果您的模型已在內部執行非最大值抑制,請勾選此項。否則 Agent 會自行執行 NMS。NMS 控制結果矩形的篩選方式。
- 預設 NMS:設定 NMS 的重疊限制器(預設為 45% 重疊)。
新增模型後,您的裝置的物件辨識標籤中將可以使用該模型。如果遇到問題,您可以返回模型設定並進行變更。Agent 也支援重新載入模型檔案,因此您可以在其執行時將其覆蓋為新版本。
設定 AI 伺服器
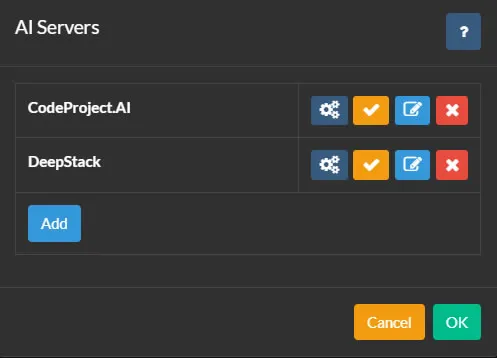
若要設定 AI 伺服器,請點擊 Agent DVR 主介面右上角的圖示。然後點擊「組態」下的「設定」,從下拉式選單中選擇「AI 設定」,並點擊「AI 伺服器」。
Agent DVR 除了內建 AI 之外,還可選擇與 CodeProject.AI 整合,提供各種 AI 功能,包括物件辨識、人臉辨識、ALPR(自動車牌辨識)及超解析度(增強)。PlateRecognizer.com 也可支援作為 ALPR 服務商。CodeProject.AI 是開源、免費的,且與大多數平台相容。
若要使用外部伺服器,請針對您的平台安裝它,然後點擊 AI 伺服器,再點擊 新增,以將 Agent DVR 連線至該伺服器。
您可以視需要為 Agent DVR 新增多個 AI 伺服器。Agent DVR 中的攝影機可以設定為針對每個功能使用不同的 AI 伺服器,或者您可以為所有工作項目清單使用一個 AI 伺服器。
設定您的伺服器
- 名稱:為您的伺服器命名,例如「貓咪捕捉器」。
- AI 伺服器 URL:輸入您的 AI 伺服器的 URL,例如 http://localhost:32168/
- API 金鑰:輸入您的金鑰 (如已設定,此為選用項目)。
- 逾時時間:伺服器要求的逾時時間 (以秒為單位)。
- 重試延遲時間:重試對該伺服器的失敗要求之前等待的時間 (以秒為單位)。
點擊「確定」以儲存您的設定。
使用 OpenAI
若要設定 OpenAI ("ChatGPT") 以回答有關您影片串流中發生情況的問題,請瀏覽至伺服器設定 - AI 設定,並在詢問 AI 下選擇「OpenAI」。
- 網址 (URL):輸入服務的網址。預設值為「https://api.openai.com/v1/responses」。
- OpenAI API 金鑰:在向 OpenAI 註冊後,前往API 金鑰頁面並產生新的金鑰密文。將此金鑰複製並貼入指定欄位。
- 模型:指定要使用的模型。預設值為 gpt-5.4-mini。OpenAI 可能會在稍後移除或變更此項。
- 最大權杖數:這會設定每個要求的最大權杖使用量。如果遇到問題,請在 /logs.html 查看日誌,因為這可能與權杖使用量相關。
設定 OpenAI 後,請參閱詢問 AI 以了解如何使用它來回答有關您攝影機串流中發生情況的一般問題。
使用 Claude
若要設定 Claude AI 來回答您影片串流中發生的事情,請導航至伺服器設定 - AI 設定,並在詢問 AI 下選擇「Claude」。
- 網址 (URL):輸入服務的網址。預設值為「https://api.anthropic.com/v1/messages」。
- Claude API 金鑰:註冊 Claude 後,請訪問 API 金鑰頁面並建立新的金鑰密文。複製此金鑰並將其貼入欄位中。
- 版本:指定要使用的 API 版本。預設值為 2023-06-01。此版本可能會在某個時刻被 Anthropic 移除或變更。
- 模型:指定要使用的模型。書寫聲時的預設值為 claude-sonnet-4-6(Claude Sonnet 4.6)。
- 最大權杖數:此選項控制每個請求的最大金鑰花費。如果遇到問題,請查看 /logs.html 的日誌,因為可能與金鑰花費有關。
設定 Claude 後,請參閱 詢問 AI 了解如何使用它來識別攝影機串流中的一般情況。
使用 Gemini
若要設定 Gemini 以回答有關您的影片饋送中發生情況的問題,請瀏覽至伺服器設定 - AI 設定,並在詢問 AI 下選擇「Gemini」。
- 網址 (URL):輸入服務的網址。預設值為「https://generativelanguage.googleapis.com」。
- Gemini API 金鑰:註冊 Gemini 後,請造訪 API 金鑰頁面並建立新的金鑰密文。複製此金鑰並貼到欄位中。
- 版本:指定要使用的 API 版本。預設值為 v1beta。Google 可能會隨時移除或變更此項目。
- 模型:指定要使用的模型。在書寫聲時的預設值為 gemini-2.5-flash。輸入 API 金鑰後,Agent 將列出您帳戶可用的視覺模型。
- 最大權杖數:此選項控制每個請求的最大金鑰花費。如果遇到問題,請查看 /logs.html 的日誌,因為可能與金鑰花費有關。
Gemini 設定完成後,請參閱詢問 AI 以了解如何用它來識別攝影機饋送中的一般情況。
使用其他 LLM 伺服器
您可以使用自己的本機 LLM 伺服器(例如 vLLM、Ollama 和 LM Studio)來描述 Agent DVR 從您的攝影機在警示事件中擷取的影像,並回答關於您影片串流中正在發生什麼的問題。請參閱 描述和 詢問 AI。
若要設定本機 AI 伺服器,請前往伺服器設定 - AI 設定,然後點擊您想要使用的 LLM(Ollama、vLLM 或 LM Studio)旁的設定按鈕。
- URL:指定您的 LLM 伺服器執行所在的端點。預設值 URL 為:
- Ollama:
http://localhost:11434/api/chat - vLLM:
http://localhost:8000/v1/chat/completions - LM Studio:
http://localhost:1234/v1/chat/completions
- Ollama:
- API 金鑰:如果您的 LLM 伺服器需要驗證,請在此輸入 API 金鑰。大多數本機伺服器不需要此項,除非特別設定。
- 模型:選擇具備視覺功能的模型以用於影像分析。您必須已在您的 LLM 伺服器中下載並載入此模型。Agent 建議一些受歡迎的選項,包括:
- Qwen VL 模型(高效能)
- Gemma 4(大小範圍良好)
- Llama 3.2 Vision(Meta)
- Mistral Small 3.1
- moondream(非常小型,適合低階硬體,僅限 Ollama)
- 溫度:控制回應中的創意性與準確性(0.0-1.0)。較低的值(0.3-0.4)會產生更多實際、一致的描述。較高的值(0.6-0.8)會產生更多樣化、創意性的回應。建議值:0.4 用於安全攝影機分析。
- 最大權杖數:AI 回應中的最大字數/權杖數。較高的值允許更詳細的描述,但產生時間更長。建議值:300-500 用於詳細影像分析,150-250 用於簡短描述。
- top_p:通過限制詞彙選擇來控制回應多樣性(0.0-1.0)。較低的值使用更常見的單詞,較高的值允許更多樣的詞彙。建議值:0.9 以取得準確性和自然語言的良好平衡。
- top_k:限制模型從最可能的前 K 個下一個單詞中選擇。較低的值(20-40)會產生更專注的回應,較高的值(80-100)允許更多變化。建議值:50 用於可靠的影像描述。
使用 PlateRecognizer.com
若要在 Agent DVR 中設定 LPR (ANPR 或牌照辨識),請前往伺服器設定 - AI 設定,並在 Plate Recognizer 下輸入詳情。前往 Plate Recognizer 註冊免費試用。無須信用卡。
使用 DoubleTake
DoubleTake 是一個開放源始平台,提供統一的 API 用於處理臉部辨識,使用:
- CompreFace
- Amazon Rekognition
- DeepStack
- CodeProject.AI Server
- Facebox
您需要安裝並設定 DoubleTake 搭配您偏好的臉部辨識選項。
DoubleTake 設定完成後,開啟 Agent DVR 並前往伺服器設定 - AI 設定,然後點擊 DoubleTake 旁邊的設定按鈕。
輸入您的 DoubleTake 伺服器網址 (URL)(例如 http://localhost:3000/)和您的密碼(如果已設定)。
點擊確定,然後編輯攝影機並前往臉部辨識。將 AI 伺服器選項設定為 DoubleTake,並視需要設定臉部辨識。
管理 AI 模組
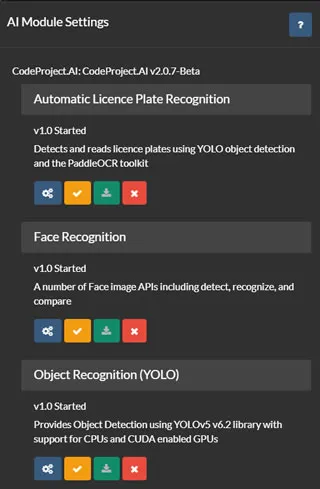
在 AI 伺服器清單中(如上所述),您可以選擇設定、測試、編輯和移除 AI 伺服器。點擊設定 按鈕以顯示所選伺服器上可用或已安裝的模組。
Agent DVR 會從您的伺服器擷取目前的模組清單,並提供使用者介面來安裝、卸載、設定和測試每個模組。支援所有預設值 CodeProject.AI 模組,但 Agent DVR 只使用其中的一部分。
若要在 Agent DVR 中使用 ALPR(自動車牌辨識)、超解析度 (Super Resolution) 或人臉辨識,您需要從此頁面安裝相應的模組。通常這些模組的預設值設定就已足夠,但您可以點擊每個模組下方的 圖示來設定它們。