について
Agent DVR には AI が組み込まれているため、オブジェクト認識、顔認証、またはナンバープレート認識に外部 AI サーバーは不要です。組み込み AI は有効にするまでオフになっています。これにはライセンス(またはアクティブなサブスクリプション)が必要であり、オブジェクト認識、顔認証、または LPR タブでカメラごとにオンにします。AI サーバーは内部に設定したままにしてモデルを選択します(Agent が組み込みモデルを自動的にダウンロードします)。ローカルオブジェクト認識を参照してください。外部 AI サーバーはオプションです。
組み込まれた AI 以上の機能を使用したい場合、Agent DVR は DeepStack AI、CodeProject AI、PlateRecognizer.com、Claude、Gemini、OpenAI (ChatGPT) などの AI サーバーと、Ollama、vLLM、LM Studio などのローカル LLM と完全に統合され、スマート アラート フィルタリング、オブジェクト認識、シーン認識、インテリジェント イベント制御を追加できます。
DeepStack と CodeProject AI に加えて、同じ API をサポートする他の AI サーバーも使用できます。
オブジェクト認識とコンピュータビジョン
- https://codeproject.github.io/ - クロスプラットフォーム GPU/CPU ベースの AI 処理サーバー
- https://docs.platerecognizer.com/ - ナンバープレート認識サーバー (Web ベース API)
- https://github.com/runningman84/docker-coral-rest-server - RPi (または Linux/Mac) 上の Tensorflow-lite モデルと Coral USB スティックからの加速
- https://github.com/robmarkcole/coral-pi-rest-server/ - Flask アプリ経由の Coral USB アクセラレータ上の Tensorflow-lite モデル
- https://xnorpx.github.io/blue-onyx/ - Blue Onyx オブジェクト検出サービス
クラウド AI サービス
- https://platform.openai.com/ - OpenAI API (ChatGPT、GPT-4 Vision) - 画像分析とチャット用
- https://console.anthropic.com/ - Anthropic Claude API - 高度な推論と画像理解用
- https://ai.google.dev/ - Google Gemini API - マルチモーダル AI 機能用
- https://docs.anthropic.com/ - Claude API ドキュメント
- https://platform.openai.com/docs/ - OpenAI API ドキュメント
- https://ai.google.dev/gemini-api/docs - Gemini API ドキュメント
ローカル AI サーバー (LLM)
- https://ollama.com/ - Ollama: 大規模言語モデルをローカルで実行
- https://docs.vllm.ai/ - vLLM: 高スループット LLM 推論とサービング
- https://lmstudio.ai/ - LM Studio: ローカル LLM 用の使いやすいデスクトップアプリ
- https://github.com/ollama/ollama - Ollama GitHub リポジトリ
- https://github.com/vllm-project/vllm - vLLM GitHub リポジトリ
AIモデルの追加
カスタム AI モデルを使用すると、Agent DVR のオブジェクト検出を組み込みオプション以外に拡張できます。例えば、野生動物、配送車両、または訓練されたモデルが検出できるその他のものを認識できます。独自のモデルファイルを Agent DVR に追加するには、サーバー設定 > AI 設定に移動して、AI モデルの下にあるオブジェクト認識をクリックします。Agent には、Agent DVR 用にパフォーマンスが調整された 2 つの事前構築モデルが付属しています。
モデルを構成する前に、Agent DVR のモデルフォルダに追加する必要があります (AI モデルの構築を参照)。これは通常、Agent/Media/Models/ONNXにあります (パスは OS によって異なる場合があります)。完全なパスは、不明な場合はモデルの追加ページに表示されます。Agent は.onnxモデルを使用します。Python 工具類を使用して、他の AI モデル形式を ONNX に変換できます。
モデルを構築してコピーしたら、Agent に追加するのは簡単です。クリックしてモデルを追加します:
- モデルに名前を付けます:モデルに名前を付けます。好きな名前を付けることができます。
- 説明:モデルが何をするかの説明 (オプション)。
- モデルファイル:フォルダにコピーしたモデルのファイル名を選択します。
- ラベル:モデルが検索するラベル (または「クラス」) のリストを CSV 形式で入力します (引用符なし、スペースは自動的に削除されます)。
- レイアウト:モデルが NCHW か NHWC かを選択します。不明な場合は、ほとんどのモデルは NCHW です。
- チャンネル順序:モデルが RGB または BGR で画像を必要とするかを選択します。ほとんどのモデルは RGB を使用します。モデルがシングルチャンネル (グレースケール) の場合、これは無視されます。
- 正規化:データをモデルで使用する前にどのように正規化するかを選択します。ほとんどのモデルは再スケーリング (0-1) を使用します。これにより、ピクセル値が 255 で除算されます。
- 画像のパディング:これにより、画像を入力寸法に拡大するか、黒いバーでパディングするかを制御します。通常は、精度を高めるため画像をパディングする方が良いです。
- NMS あり:モデルが既に内部で Non-Maximum Suppression を実行する場合は、このチェックボックスをオンにします。そうでない場合、Agent は NMS を自体で実行します。NMS は結果の矩形がフィルタリングされる方法を制御します。
- デフォルトの NMS:NMS の重複リミッターを設定します (既定値は 45% の重複)。
モデルを追加すると、デバイスのオブジェクト認識タブで使用できるようになります。問題がある場合は、モデル設定に戻って変更を加えることができます。Agent はモデルファイルの再ロードもサポートしているため、実行中に新しいバージョンでそれを上書きできます。
AI サーバーの設定
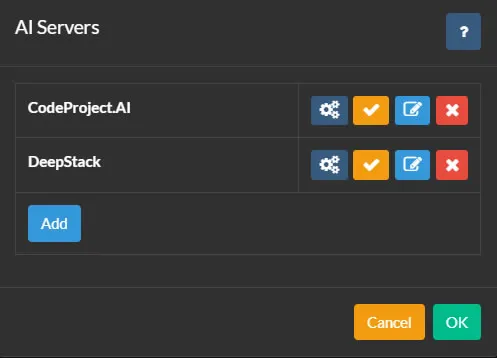
AI サーバーを設定するには、Agent DVR メイン UI の右上にある アイコンをクリックします。その後、設定 の下の 設定 をクリックし、ドロップダウン メニューから AI 設定 を選択して、AI サーバー をクリックします。
組み込み AI の代替オプションとして、Agent DVR は CodeProject.AI と統合しており、オブジェクト認識、顔認証、ALPR(自動ライセンスプレート認識)、超解像度処理(強化)など、様々な AI 機能を提供します。PlateRecognizer.com も ALPR プロバイダーとしてサポートされています。CodeProject.AI はオープンソースで無料であり、ほとんどのプラットフォームに対応しています。
外部サーバーを使用するには、お使いのプラットフォーム向けにインストールし、AI サーバーをクリックしてから追加をクリックして、Agent DVR をそれに接続します。
必要に応じて、Agent DVR に複数の AI サーバーを追加できます。Agent DVR のカメラは、各機能に異なる AI サーバーを使用するように設定することも、すべてのタスクに 1 つの AI サーバーを使用することもできます。
サーバーの設定
- 名前: サーバーに名前を付けます。例: Cat Catcher。
- AI サーバー URL: AI サーバーの URL を入力します。例: http://localhost:32168/
- API キー: 設定されている場合はキーを入力します (オプション)。
- タイムアウト: サーバー リクエストのタイムアウト (秒単位)。
- 再試行の遅延時間: このサーバーへの失敗したリクエストを再試行する前の時間 (秒単位)。
OK をクリックして設定を保存します。
OpenAIを使用
OpenAI ("ChatGPT") をビデオフィードで何が起きているかについての質問に答えるように設定するには、「サーバー設定」 - 「AI 設定」に移動し、「AI に質問」の下で「OpenAI」を選択します。
- URL: サービスの URL を入力してください。既定値は「https://api.openai.com/v1/responses」です。
- OpenAI API キー: OpenAI に登録した後、API キーページに移動し、新しい秘密鍵を生成してください。このキーをコピーして指定されたフィールドに貼り付けます。
- モデル: 使用するモデルを指定してください。既定値はgpt-5.4-miniです。OpenAI は後でこれを削除または変更する可能性があります。
- トークン数の上限: リクエストごとのトークン使用の最大値を設定します。問題が発生した場合は、/logs.html のログを確認してください。トークン使用に関連している可能性があります。
OpenAI が設定されたら、AI に質問を参照して、カメラフィードで何が起きているかについての一般的な質問に答えるために使用する方法の手順を確認してください。
Claude を使用する
ビデオフィードで起きていることについて Claude AI に質問に答えてもらうように設定するには、「サーバー設定」- 「AI 設定」に移動して、「AI に質問」の下で「Claude」を選択します。
- URL: サービスへの URL を入力します。既定値は「https://api.anthropic.com/v1/messages」です。
- Claude API キー: Claude にサインアップした後、API キーページにアクセスして、新しい秘密鍵を作成します。このキーをコピーしてフィールドに貼り付けます。
- バージョン: 使用する API バージョンを指定します。既定値は2023-06-01です。これは Anthropic によっていつでも削除済みにされたり変更されたりする可能性があります。
- モデル: 使用するモデルを指定します。書き込み音時点での既定値はclaude-sonnet-4-6(Claude Sonnet 4.6)です。
- トークン数の上限: これはリクエストあたりのトークン数の上限の使用を制御します。問題がある場合は、トークン数の使用に関連している可能性があるため、/logs.html のログを確認してください。
Claude を設定した後、AI に質問を参照して、カメラフィードで一般的なシナリオを認識するために使用する方法を確認します。
Gemini を使用する
ビデオフィードで何が起きているかについて質問に答えるよう Gemini を設定するには、サーバー設定 - AI 設定 に移動し、「AI に質問」の下から「Gemini」を選択してください。
- URL: サービスへの URL を入力してください。既定値は「https://generativelanguage.googleapis.com」です。
- Gemini API キー: Gemini にサインアップした後、API キーページにアクセスして新しい秘密鍵を作成してください。このキーをコピーしてフィールドに貼り付けてください。
- バージョン: 使用する API バージョンを指定してください。既定値は v1beta です。Google によっていつでも削除または変更される可能性があります。
- モデル: 使用するモデルを指定してください。書き込み音時点での既定値は gemini-2.5-flash です。API キーを入力すると、Agent はアカウントで利用可能なビジョンモデルを一覧表示します。
- トークン数の上限: これはリクエストあたりのトークン数の上限の使用を制御します。問題がある場合は、トークン数の使用に関連している可能性があるため、/logs.html のログを確認してください。
Gemini を設定した後は、AI に質問を参照して、カメラフィードで一般的なシナリオを認識するために使用する方法を確認してください。
他のLLMサーバーを使用する
Agent DVR がカメラから取得した画像を、アラート イベントで説明したり、ビデオ ストリームで起きていることについての質問に答えたりするために、独自のローカル LLM サーバー(vLLM、Ollama、LM Studio など)を使用できます。記述するとAI に質問を参照してください。
ローカル AI サーバーを構成するには、サーバー設定 - AI 設定に移動し、使用する LLM(Ollama、vLLM、LM Studio)の横にある構成ボタンをクリックします。
- URL: LLM サーバーが実行されているエンドポイントを指定します。既定値 の URL は以下の通りです:
- Ollama:
http://localhost:11434/api/chat - vLLM:
http://localhost:8000/v1/chat/completions - LM Studio:
http://localhost:1234/v1/chat/completions
- Ollama:
- API キー: LLM サーバーが認証を必要とする場合は、API キーをここに入力します。ほとんどのローカル サーバーは、特に設定されていない限り、これを必要としません。
- モデル: 画像分析に使用するビジョン対応モデルを選択します。このモデルを LLM サーバーに既ダウンロードして読み込んでおく必要があります。Agent は以下を含む、いくつかの一般的なオプションを提案しています:
- Qwen VL モデル(高パフォーマンス)
- Gemma 4(幅広いサイズ)
- Llama 3.2 Vision(Meta)
- Mistral Small 3.1
- moondream(非常に小さく、ローエンド ハードウェアに適しており、Ollama のみ)
- 温度: 応答における創造性と正確性を制御します(0.0-1.0)。低い値(0.3-0.4)は、より事実的で一貫性のある説明を生成します。高い値(0.6-0.8)は、より多様で創造的な応答を生成します。推奨: セキュリティ カメラ分析の場合は 0.4。
- トークン数の上限: AI の応答における単語/トークンの最大数。高い値は、より詳細な説明を可能にしますが、生成に時間がかかります。推奨: 詳細な画像分析には 300-500、簡潔な説明には 150-250。
- top_p: 語彙選択を制限することで応答の多様性を制御します(0.0-1.0)。低い値はより一般的な単語を使用し、高い値はより多様な語彙を許可します。推奨: 正確性と自然な言語のバランスの取れた値として 0.9。
- top_k: モデルを最も可能性の高い次の単語 K 個の選択に制限します。低い値(20-40)はより焦点の絞られた応答を生成し、高い値(80-100)はより多くの多様性を許可します。推奨: 信頼性の高い画像説明には 50。
PlateRecognizer.comの使用
Agent DVR で LPR (ANPR またはナンバープレート認識) を構成するには、サーバー設定 - AI 設定に移動し、Plate Recognizer の下に詳細情報を入力します。Plate Recognizer で無料トライアルにサインアップします。クレジットカードは不要です。
ダブルテイクの使用
DoubleTakeはオープンソースプラットフォームで、以下を使用した顔認識処理のための統一APIを提供します:
- CompreFace
- Amazon Rekognition
- DeepStack
- CodeProject.AI Server
- Facebox
DoubleTakeをインストールして構成し、希望する顔認識オプションで設定する必要があります。
DoubleTakeのセットアップが完了したら、Agent DVRを開いて「サーバー設定 - AI 設定」に移動し、DoubleTakeの隣にある「構成」ボタンをクリックします。
DoubleTakeサーバーのURL(例:http://localhost:3000/)と、設定されている場合はパスワードを入力します。
「OK」をクリックしてからカメラを編集して「顔認識」に移動します。「AI サーバー」オプションをDoubleTakeに設定し、必要に応じて顔認識を構成します。
AI モジュールの管理
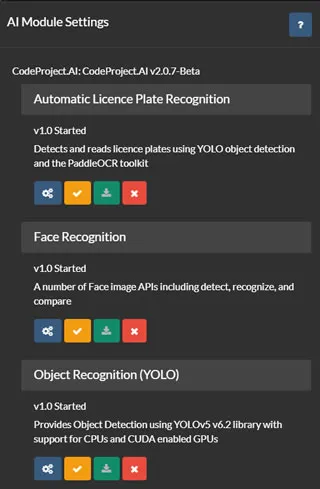
AI サーバーのリスト(上記を参照)では、AI サーバーを構成、テスト、編集、および削除するオプションがあります。構成の ボタンをクリックして、選択したサーバー上で利用可能またはインストール済みのモジュールを表示します。
Agent DVR はサーバーから現在のモジュールリストを取得し、各モジュールをインストール、アンインストール、構成、およびテストするためのユーザーインターフェースを提供します。すべてのデフォルト CodeProject.AI モジュールをサポートしていますが、Agent DVR はこれらのうちのサブセットのみを使用します。
Agent DVR で ALPR(自動ナンバープレート認識)、超解像度処理、または顔認証を使用するには、このページから該当するモジュールをインストールする必要があります。通常、これらのモジュールはデフォルト設定で十分ですが、各モジュールの下にある アイコンをクリックして構成することができます。